文章列表
-
- Python Scrapy框架:通用爬虫之CrawlSpider用法简单示例
- 本文实例讲述了Python Scrapy框架:通用爬虫之CrawlSpider用法。分享给大家供大家参考,具体如下:步骤01: 创建爬虫项目scrapy startproject quotes步骤02: 创建爬虫模版scrapy genspider -t quotes quotes.toscrape...
- 日期:2022-07-30
- 浏览:102
-
- Python Scrapy多页数据爬取实现过程解析
- 1.先指定通用模板url = ’https://www.qiushibaike.com/text/page/%d/’#通用的url模板pageNum = 12.对parse方法递归处理parse第一次调用表示的是用来解析第一页对应页面中的数据对后面的页码的数据要进行手动发送if self.pageN...
- 日期:2022-07-21
- 浏览:399
-
- python中scrapy处理项目数据的实例分析
- 在我们处理完数据后,习惯把它放在原有的位置,但是这样也会出现一定的隐患。如果因为新数据的加入或者其他种种原因,当我们再次想要启用这个文件的时候,小伙伴们就会开始着急却怎么也翻不出来,似乎也没有其他更好的搜集办法,而重新进行数据整理显然是不现实的。下面我们就一起看看python爬虫中scrapy处理项...
- 日期:2022-07-04
- 浏览:382
-
- python Scrapy框架原理解析
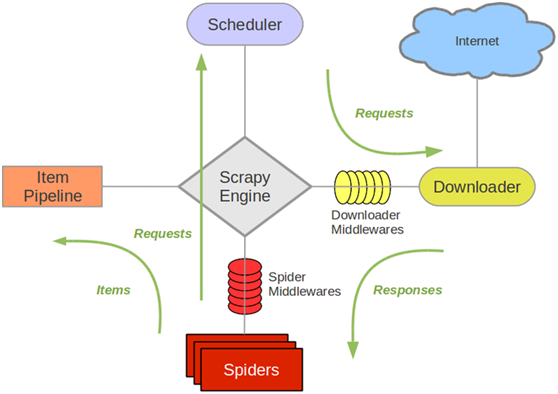
- Python 爬虫包含两个重要的部分:正则表达式和Scrapy框架的运用, 正则表达式对于所有语言都是通用的,网络上可以找到各种资源。如下是手绘Scrapy框架原理图,帮助理解如下是一段运用Scrapy创建的spider:使用了内置的crawl模板,以利用Scrapy库的CrawlSpider。相对...
- 日期:2022-06-30
- 浏览:240
-
- Django结合使用Scrapy爬取数据入库的方法示例
- 在django项目根目录位置创建scrapy项目,django_12是django项目,ABCkg是scrapy爬虫项目,app1是django的子应用2.在Scrapy的settings.py中加入以下代码import osimport syssys.path.append(os.path.dir...
- 日期:2024-09-11
- 浏览:182
- 标签: Django
-
- Python scrapy爬取小说代码案例详解
- scrapy是目前python使用的最广泛的爬虫框架架构图如下解释: Scrapy Engine(引擎): 负责Spider、ItemPipeline、Downloader、Scheduler中间的通讯,信号、数据传递等。 Scheduler(调度器): 它负责接受引擎发送过来的Request请...
- 日期:2022-07-18
- 浏览:188
-
- Python爬虫实例——scrapy框架爬取拉勾网招聘信息
- 本文实例为爬取拉勾网上的python相关的职位信息, 这些信息在职位详情页上, 如职位名, 薪资, 公司名等等.分析思路分析查询结果页在拉勾网搜索框中搜索’python’关键字, 在浏览器地址栏可以看到搜索结果页的url为: ’https://www.lagou.com/jobs/list_pyth...
- 日期:2022-07-17
- 浏览:302
-
- python中用Scrapy实现定时爬虫的实例讲解
- 一般网站发布信息会在具体实现范围内发布,我们在进行网络爬虫的过程中,可以通过设置定时爬虫,定时的爬取网站的内容。使用python爬虫框架Scrapy框架可以实现定时爬虫,而且可以根据我们的时间需求,方便的修改定时的时间。1、Scrapy介绍Scrapy是python的爬虫框架,用于抓取web站点并从...
- 日期:2022-06-29
- 浏览:164
-
- python实现Scrapy爬取网易新闻
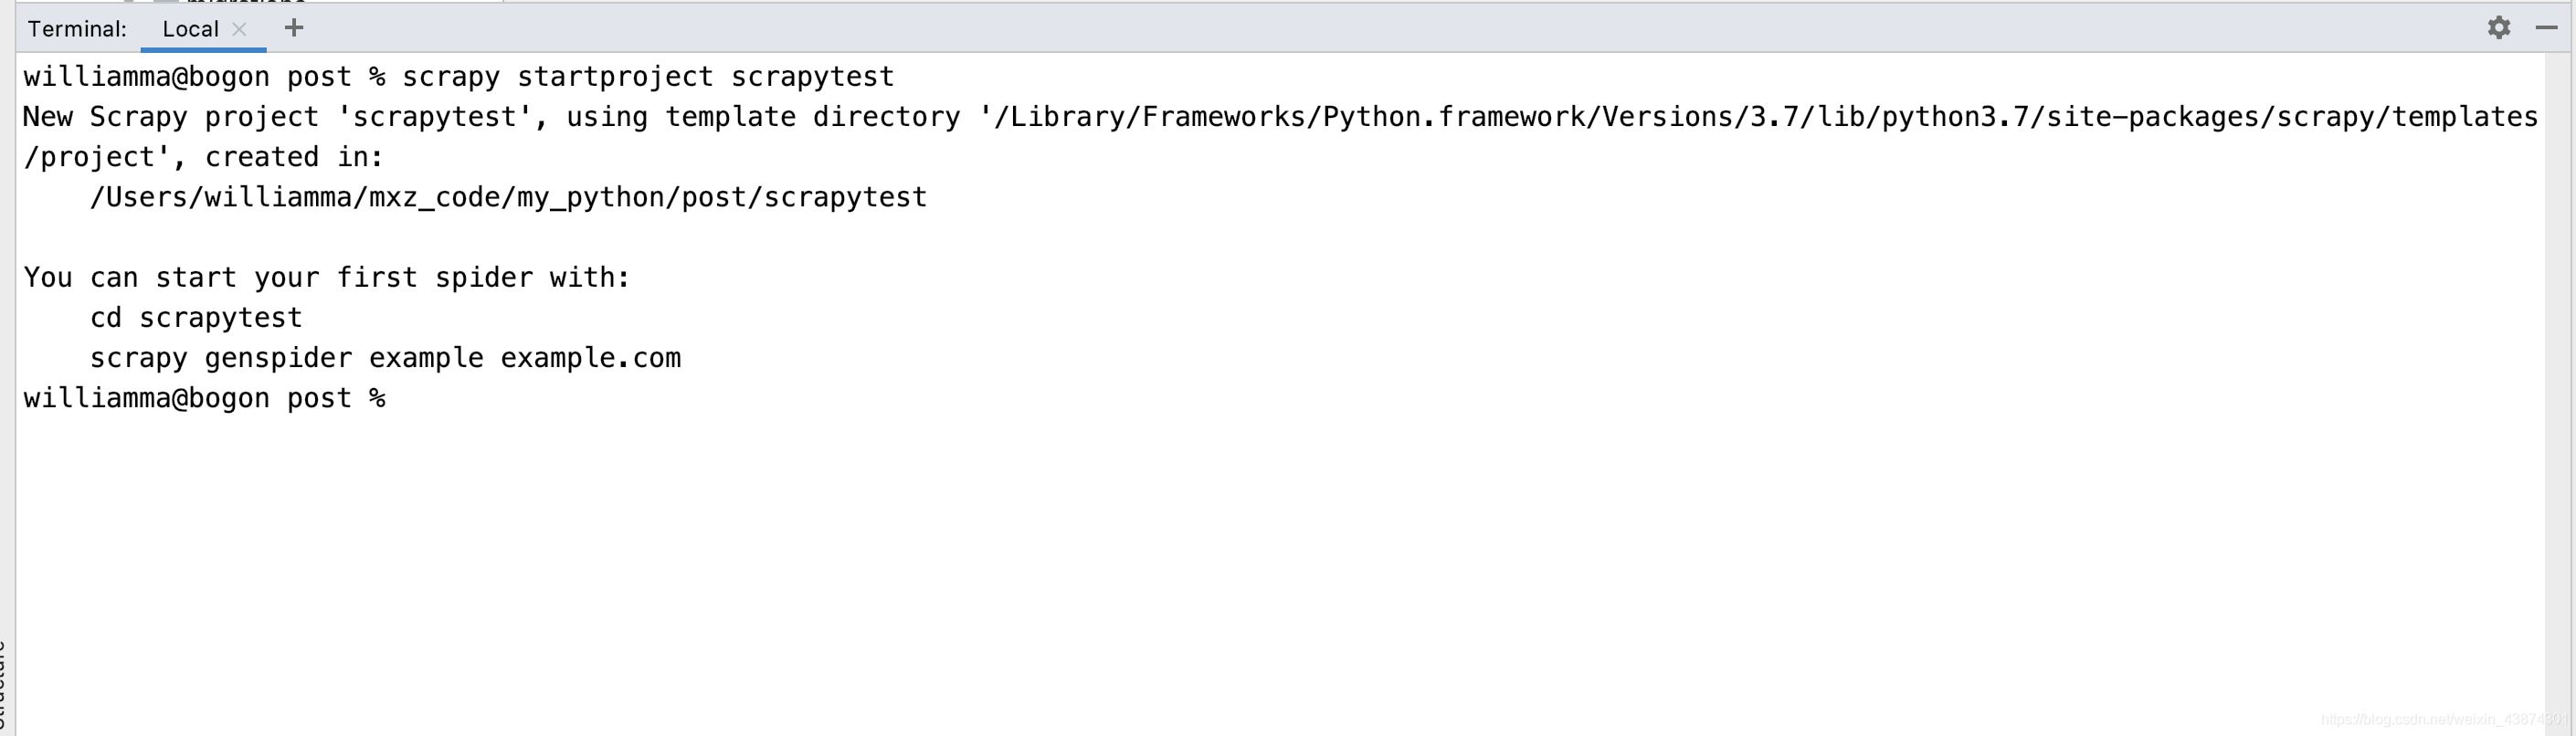
- 1. 新建项目在命令行窗口下输入scrapy startproject scrapytest, 如下然后就自动创建了相应的文件,如下2. 修改itmes.py文件打开scrapy框架自动创建的items.py文件,如下# Define here the models for your scraped...
- 日期:2022-06-24
- 浏览:294
-
- python基于scrapy爬取京东笔记本电脑数据并进行简单处理和分析
- 一、环境准备 python3.8.3 pycharm 项目所需第三方包pip install scrapy fake-useragent requests selenium virtualenv -i https://pypi.douban.com/simple1.1 创建虚拟环境...
- 日期:2022-06-22
- 浏览:347
排行榜
 网公网安备