文章详情页
网页爬虫 - 关于python beautifullsoup解析网页内容丢失的问题?
浏览:244日期:2022-09-23 08:23:07
问题描述

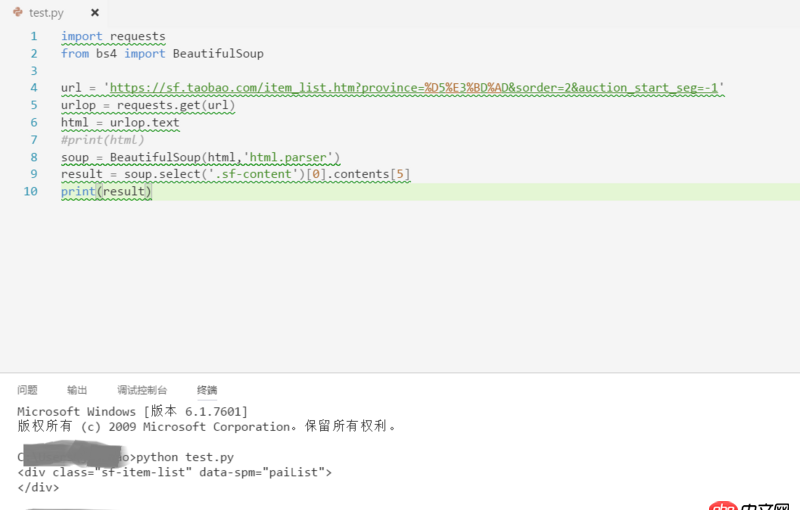
待解析页面的部分代码如第一幅图所示,我自己写的代码及运行结果如第二幅图所示。看到已经有答主提问解析页面丢失是因为用的是lxml的解析方式,我想说我一直用的是html.parser的方式。希望各位大神不吝赐教~
问题解答
回答1:你们从来都不考虑javascript动态加载的吗?
回答2:题主,如果你用Chrome F12看的话,里面是会有动态加载的内容的,而这些内容你直接请求页面的url是拿不到的。建议你点右键查看网页源代码,对照着F12里面的内容来看,源代码里没有的内容,就去查看Network里的其他请求,看有没有你需要的数据。
相关文章:
1. MySQL分表之后如何做排序的问题2. css3动画 - css3 transition设置多个属性的时候不能只用逗号分隔?3. docker绑定了nginx端口 外部访问不到4. java - 如何修改Eclipse项目那一块的背景颜色?5. 前端 - css自定义字体6. angular.js - angular中的a标签不起作用7. java - 接口中的成员变量怎么不是常量了?8. html - 如何删除css文件中没有被引用的类?9. mysql在进行insert select的时候,有的字段跟关键字重复怎么处理?10. java - 为什么第一个线程已经释放了锁,第二个线程却不行?
排行榜
 网公网安备