Python如何利用Selenium或者PhantomJS爬取动态网页内容
问题描述
想用python做股票量化交易,第一步就是获取股票的历史数据。访问http://data.eastmoney.com/sto...网页,将网页源码打开后看不见表格中的数据,据说是利用ajax技术加载的。在网上看见可以利用selenium和phantomJS来获取这些动态网页内容,但是不知道如何获取完整源码。请高手指点迷津
问题解答
回答1:事实上,我刚才试了一下,页面不是用xhr加载的,在页面的源代码中已经有了,然后调用了一个类把数据加载为一个table。比如,首页的数据:
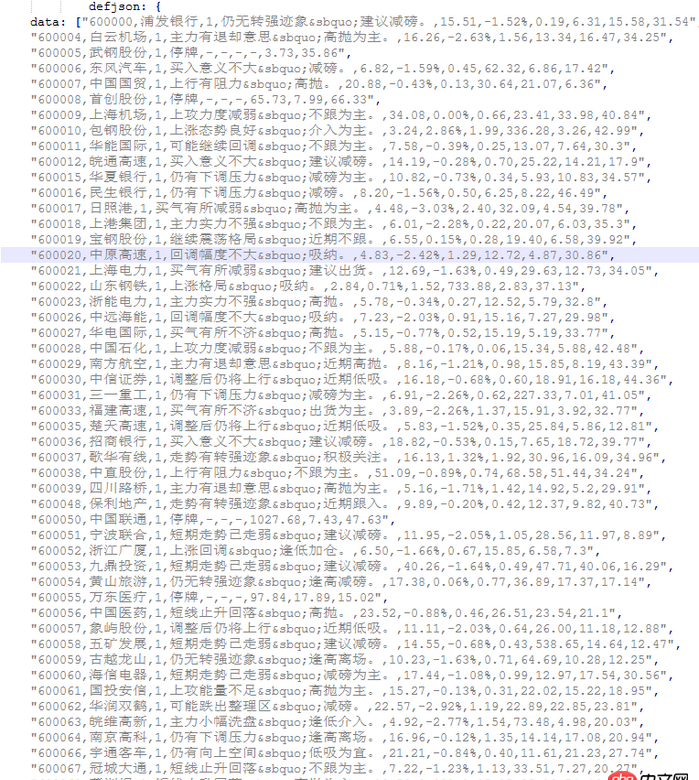
然后,提取就直接使用re提取就可以了,得到文本以后json解析就好了。先写到这里。+++++++++++++++++++++++++++++++++++++++++
然后,就是这个网站不使用xhr加载数据而是使用的js来加载json数据,动态解析来显示。具体分析需要用到js的知识,如果你了解也可以自己尝试解析。
我尝试了一下。
from urllib.parse import quoteimport timeimport requestsurl = 'http://datainterface.eastmoney.com/EM_DataCenter/JS.aspx?type=FD&sty=TSTC&st={sortType}&sr={sortRule}&p={page}&ps={pageSize}&js=var {jsname}=(x){param}'params = { 'sortType': 1, 'sortRule': 1, 'page': 2, 'pageSize': 50, 'jsname': 'Aafdafgq', # 这里使用的是随机字符串,8位 'param': '&mkt=0&rt='}params['param'] += str(int(time.time()/30)) # 当前时间url = url.format(**params)url = quote(url, safe=':=/?&()')req = requests.get(url)req.text
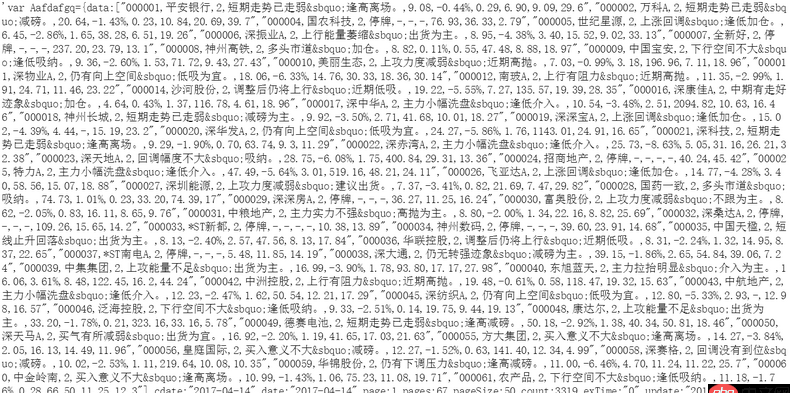
用这个组合 好处是简单暴力,坏处是效率较低。相当于打开一个你看不到的浏览器加载页面,再把运算好的结果读取。新人学爬虫的话 推荐 python网络数据采集 这本动物书。你需要的说明在采集动态页面那章。这书很薄 很实用。
回答3:我对js和json都不太了解,刚刚爬虫入门。经过你的提示,我再查看了一下源码,发现在defjson里面有这些数据,不明白是怎样把json里的数据显示到tbody里面的。我用pandas的read_html可以抓到这些数据,但是最后两列会丢失。看来我得先去看看js和json
相关文章:
1. 搜索出来的值怎样在前台显示不出来,2. python - 如何使用requests模块在一个post中提交含有多个相同名称的数据?3. css - 重写checkbox样式 用到id 与label关联实现 但是现在checkbox循环生成多项 就不能用id了 求解决办法4. js得到了我服务器上word文档的路劲,怎么展示在新的页面上5. 零基础的新手小白想学PHP开发应该从哪儿开始学起来6. thinkphp3.2.3对接新版支付宝7. javascript - 请问js(非jq)中如果获取元素的高度精准到小数位8. mysql5.7 安装后无法设置密码9. css - -moz-box-shadow这么写在火狐上没有效果怎么回事10. CSS3 box-shadow如何设置,或者用什么方法可以产生图中这样阴影的效果。
 网公网安备