Python中如何将爬取到的数据循环存入到csv文件中?
问题描述
求大神指导 再此感激不尽!!!
我想要把输出的结果存入到csv文件中
我的代码如下:(Python 需要3.5版本的)
# coding:utf-8import requestsimport jsonimport timetime_unix = time.time()time_unix = str(time_unix).split(’.’)[0]headers = { ’Host’: ’sec.wedengta.com’, ’User-Agent’: ’Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.113 Safari/537.36’, ’Connection’: ’keep-alive’, ’Content-Language’: ’zh-CN,zh;q=0.8’, ’Accept’: ’application / json’, # ’Accept-Language’: ’ zh-CN,zh;q=0.8,en-US;q=0.5,en;q=0.3’, ’X-Requested-With’: ’XMLHttpRequest’, ’Referer’: ’https://sec.wedengta.com/findPool.html?dt_from=web&title=%E8%85%BE%E8%AE%AF%E6%B6%A8%E5%81%9C%E6%9D%BF%E9%A2%84%E6%B5%8B%20-%20%E5%8E%86%E5%8F%B2%E6%8E%A8%E8%8D%90&id=99970_56&webviewType=userActivitesType&dt_page_type=11&timeStamp=1488801827765&barType=null&accessp=null’, ’Accept-Encoding’: ’gzip, deflate, br’ }url = ’https://sec.wedengta.com/getIntelliStock?action=IntelliSecPool&id=99970_56&_={0}’.format(time_unix)request = requests.get(url, headers=headers)temp = str(json.loads(request.text)).replace(’’, ’’)dic = eval(temp)content = dic[’content’]content = eval(content)vtDaySec = content[’vtDaySec’]for every in vtDaySec: for every_company in every[’vtSec’]:print(every[’sOptime’])print(every_company[’sChnName’])print(every_company[’sDtCode’][4:])print(’n’)
运行出来结果截图: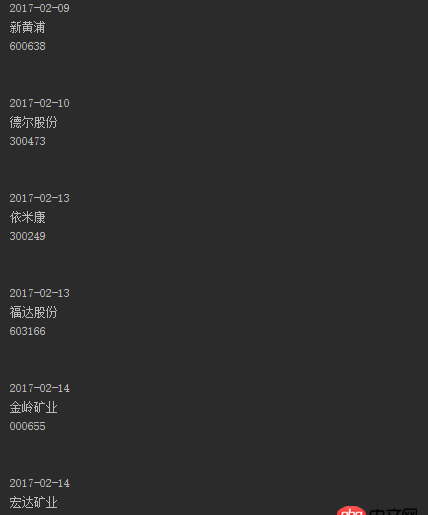
我想要的结果是: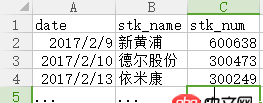
问题解答
回答1:#coding=utf-8import requestsimport jsonimport timeimport csvimport codecsheaders = { ’User-Agent’: ’Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.113 Safari/537.36’}url = ’https://sec.wedengta.com/getIntelliStock?action=IntelliSecPool&id=99970_56&_={0}’.format(time.time())r = requests.get(url, headers=headers)result = json.loads(r.text)rows = []for every in json.loads(result[’content’])[’vtDaySec’]: for company in every[’vtSec’]:row = ( every[’sOptime’].encode(’utf-8’), company[’sChnName’].encode(’utf-8’), company[’sDtCode’][4:].encode(’utf-8’))rows.append(row)with codecs.open(’company.csv’, ’wb’) as f: f.write(codecs.BOM_UTF8) writer = csv.writer(f) writer.writerow([’date’, ’stk_name’, ’stk_num’]) writer.writerows(rows)回答2:
csv = open(’data.csv’, ’w’)for every in vtDaySec: for every_company in every[’vtSec’]:csv.write(’,’.join([every[’sOptime’], every_company[’sChnName’], every_company[’sDtCode’][4:]]) + ’n’)csv.close()
相关文章:
1. javascript - react 中绑定事件和阻止事件冒泡2. css3 - css line-height和font-size高度问题,谁能帮忙解释一下呢3. java - .jsp页面用<%= %>的方式获取数据存在一个很奇怪的问题4. javascript - git clone 下来的项目 想在本地运行 npm run install 报错5. sping - Spring注入,在XML配置中引用JavaConfig,结果找不到Config中的bean6. javascript - requestAnimationFrame如何控制帧速?7. css3 - border-bottom 的长度可否超过盒子的宽度呢?实现如下图效果。(我的书下面的线)8. vue.js - nginx怎么修改跨域配置?9. 一道使用算法解决的java题(关于hashmap的问题)10. java - umeng分享中遇到找不到方法
 网公网安备