python - 网页更新数据之后无法再次抓取
问题描述
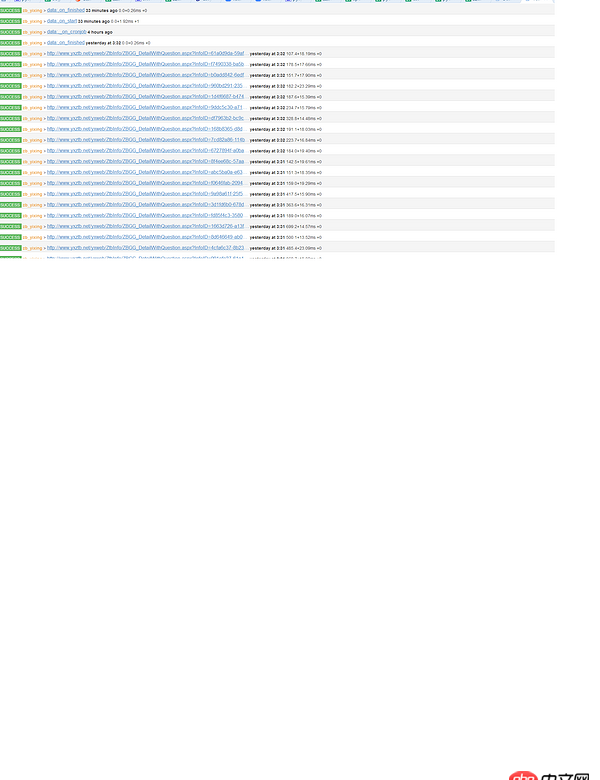
我抓取的网页今天更新了一条信息,然后爬虫运行了却没有抓取到.
from pyspider.libs.base_handler import *from pyspider.database.mysql.mysqldb import SQLclass Handler(BaseHandler): crawl_config = { } @every(minutes=24 * 60) def on_start(self):self.crawl(’http://www.yxztb.net/yxweb/zypd/012001/012001001/’, callback=self.index_page) @config(age=10 * 24 * 60 * 60) def index_page(self, response):for each in response.doc(’.tdmoreinfosub a’).items(): self.crawl(each.attr.href, callback=self.detail_page)@config(priority=2) def detail_page(self, response):return {'address':'宜兴市','url':response.url,'title':response.doc(’font span’).text(),'date' :response.doc(’#tdTitle > .webfont’).text()[8:17], }def on_result(self, result):print resultif not result or not result[’title’]: returnsql = SQL()sql.replace(’zhaobiao’,**result)
希望大佬们能讲的具体点然后多交流交流
问题解答
回答1:@config (age)参数设定直接忽略了index.page的执行
回答2:既然 on_start 的 @every 是一天,那么self.crawl 中设置 age=12 * 60 * 60 半天是比较合适的,保证每次 every 肯定不会被 age 所限制。另外 @config(age=10 * 24 * 60 * 60),这是10天内不要再爬的意思啊。
相关文章:
1. python - 用ffmpeg采集视频,用terminate没法结束进程2. react-native 启动Android项目失败3. nginx - 关于vue项目部署到ngnix后出现的问题4. java - 为什么第一个线程已经释放了锁,第二个线程却不行?5. css - 关于HTML中width和height的疑问(这个提问的标题不好起)6. gosts内容是空的7. html - css导航栏模糊,导航栏固定,随着页面滑动对下方页面产生模糊效果,如何实现?8. phpadmin的数据库,可以设置自动变化时间的变量吗?就是不需要接收时间数据,自动变化9. 微信小程序如何将获取的时间戳提交到数据库?10. javascript - tab切换点击不同的按钮显示不同的内容
 网公网安备