文章详情页
python - 怎么用爬虫批量抓取网页中的图片?
浏览:260日期:2022-06-27 11:03:37
问题描述
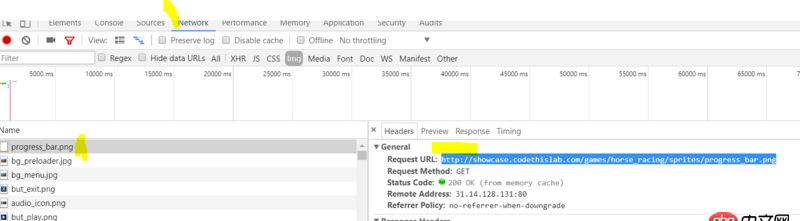
如图,通过network查看加载图片,要一张一张右键保存很麻烦,有没有办法写个爬虫批量抓取这里的图片》?
问题解答
回答1:这个需求, 如果你会爬虫其实很简单, 不外乎几个步骤:
首页或者有图片的页面, 通过正则或者其他框架, 获取图片的url
通过requests库或者urllib库, 访问上面图片url的地址
以二进制的形式, 写入本地硬盘
参考代码:
import re, requestsr = requests.get('http://...页面地址..')p = re.compile(r’相应的正则表达式匹配’)image = p.findall(r.text)[0] # 通过正则获取所有图片的urlir = requests.get(image) # 访问图片的地址sz = open(’logo.jpg’, ’wb’).write(ir.content) # 将其内容写入本地print(’logo.jpg’, sz,’bytes’)
更多详情, 可以参考学习requests官方文档: requests文档
回答2:可以的,爬虫五个部分:调度程序url去重下载器网页解析数据存储对于下载图片的思路是:获取图片所在网页内容,解析img标签,得到图片地址,然后便利图片网址,下载每张图片,将下载过的图片地址保存在布隆过滤器中,避免重复下载,每次下载一张图片时,通过网址检查是否下载过,当图片下载到本地后,可以将图片路径保存在数据库中,图片文件保存在文件夹中,或者直接将图片保存在数据库中。python使用request+beautifulsoup4java使用jsoup
回答3:如果多个网站或者一个网站需要爬到很深的情况下,楼上的方式直接递归或者深度遍历就OK
相关文章:
1. javascript - react 中绑定事件和阻止事件冒泡2. css3 - css line-height和font-size高度问题,谁能帮忙解释一下呢3. java - .jsp页面用<%= %>的方式获取数据存在一个很奇怪的问题4. javascript - git clone 下来的项目 想在本地运行 npm run install 报错5. sping - Spring注入,在XML配置中引用JavaConfig,结果找不到Config中的bean6. javascript - requestAnimationFrame如何控制帧速?7. css3 - border-bottom 的长度可否超过盒子的宽度呢?实现如下图效果。(我的书下面的线)8. vue.js - nginx怎么修改跨域配置?9. 一道使用算法解决的java题(关于hashmap的问题)10. java - umeng分享中遇到找不到方法
排行榜
 网公网安备