编码 - Python 3.6中 ’utf-8’ codec can’t decode byte invalid start byte?
问题描述
Python 3.6中,网页信息解析失败,试了很多种编码,查看网页的编码方式也是utf-8。错误信息:’utf-8’ codec can’t decode byte 0x8b in position 1: invalid start byte?还有就是第一个print终端里打印出来的unicode内容是[b’x1fx8bx08x00x...]这种格式的,之前也有过这种情况,一个print打2个变量,就是b’x, 如果分来2行打又变回了汉字。是因为什么原因呢?
# -*- coding: utf-8 -*-import json , sqlite3import urllib.requesturl = (’http://wthrcdn.etouch.cn/weather_mini?city=%E4%B8%8A%E6%B5%B7’)resp = urllib.request.urlopen(url)content = resp.read()print(content)print(type(content))print(content.decode(’utf-8’))
问题解答
回答1: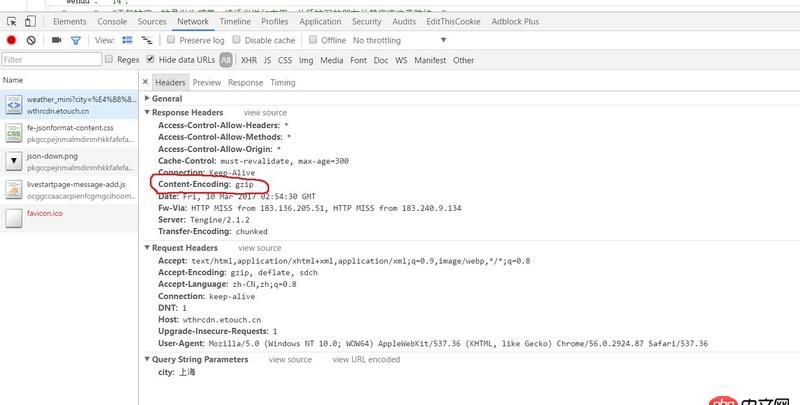
看了一下网站返回的是gzip压缩过的数据,所以要进行解码
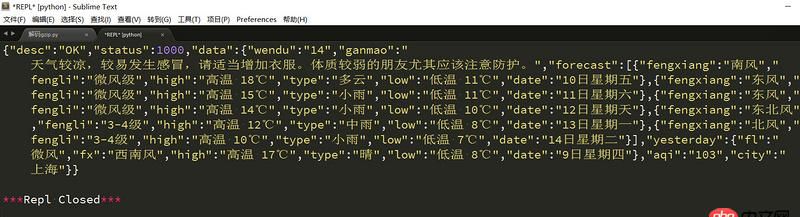
# coding=utf-8from io import BytesIOimport gzipimport urllib.requesturl = (’http://wthrcdn.etouch.cn/weather_mini?city=%E4%B8%8A%E6%B5%B7’)resp = urllib.request.urlopen(url)content = resp.read() # content是压缩过的数据buff = BytesIO(content) # 把content转为文件对象f = gzip.GzipFile(fileobj=buff)res = f.read().decode(’utf-8’)print(res)
requests不好用吗?
回答3: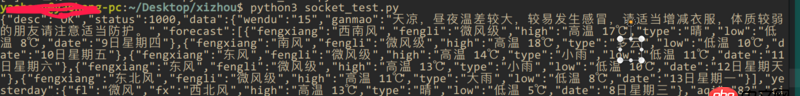
建议用requeset,代码如下:
import requestsr = requests.get(’http://wthrcdn.etouch.cn/weather_mini?city=%E4%B8%8A%E6%B5%B7’)print(r.text)回答4:
不是字符编码问题, 你看看你请求的 Respont headers
Status Code: 200 OK Access-Control-Allow-Headers: * Access-Control-Allow-Methods: * Access-Control-Allow-Origin: * Cache-Control: must-revalidate, max-age=300 Connection: Keep-Alive Content-Encoding: gzip Content-Length: 443 Date: Fri, 10 Mar 2017 03:20:46 GMT Fw-Cache-Status: hit Fw-Via: HTTP MISS from 58.59.19.99, DISK HIT from 183.131.161.27 Server: Tengine/2.1.2
是gzip, 如果用标准库的东西, 还需要把gzip 给解开
相关文章:
1. MYSQL 运算的问题2. html5 - H5中播放的视频如何有效的进行知识产权保护-防下载防盗链3. PHP类中的$this4. 前端 - date属性的input文本框在微信上会出现奇怪的边框?5. html5 - 只用CSS如何实现input框的宽度随框里输入的内容长短自动适应?6. javascript - 小米浏览器中,图片导致fixed定位的元素无法显示7. javascript - vue.js 中2个v-if 怎么处理?8. html - 急求,能否用flex或者高端点的CSS来布局这个图呢?不想用浮动或定位了9. 请教各位大佬,浏览器点 提交实例为什么没有反应10. javascript - z=z=z++里的执行过程
 网公网安备