文章详情页
网页爬虫 - Python:爬虫的中文编码问题?
浏览:359日期:2022-08-26 10:56:16
问题描述
爬取中文网页后正则匹配出中文,得打UTF-8的编码字符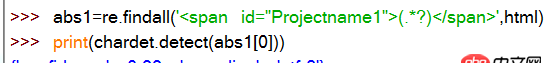
将其输出为.csv文件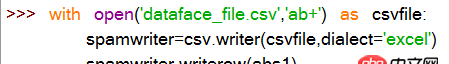
在.CSV中显示为乱码
用记事本打开.csv又可以正常显示为中文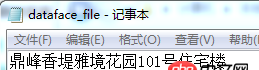
有没有大神指点是怎么一回事?怎样才能在Excel里直接看到中文?
问题解答
回答1:简单地方法是用pandas的to_excel方法转化成.xlsx文件,因为.xlsx默认编码是默认支持Excel的,区别当然是无法用记事本打开。
import pandas as pda = pd.read_csv(’./test.csv’)a.to_excel(’./test_output.xlsx’, index=False)a.to_excel(’./test_output.csv’, index=False)
我这里没有windows可以测试,可以尝试写入编码为gb2312或者gbk试试。
表格文件类I/O的话其实pandas更方便一点。
回答2:abs1=abs1.decode().encode(’gbk’)
回答3:excel默认使用的是GBK编码。
回答4:新建一个excel文件,然后点 数据 自文本,导入csv文件
相关文章:
1. 微博2输入框一些问题2. linux - 阿里云服务器上的mysql服务在客户端只能通过ssh证书连接后才能使用3. (python)关于如何做到按win+R再输入文件文件名就可以运行?4. win10 python3.5 matplotlib使用报错5. mysql - 博客文章标签表结构设计问题6. 急急国王什么梗 我是急急急急急急国王梗内涵出处介绍7. python - 图片爬虫时候遇到问题 urllib.request.urlretrieve 下载到指定文件夹不成功?8. python html如何转成PDF?9. python 中文乱码问题10. 登录mysql-front出现以下错误
排行榜
 网公网安备