如何用python免费看美剧
最早一部《越狱》转变了我对美剧的看法。主人公scofield的聪明才智和坚强的毅力,《绝命毒师》里面主人公的中年逆袭,《纸牌屋》里面老谋深算的政客,等等,这些美剧和里面鲜活的任务,至今令人记忆尤新。
最近,又迷上了美剧,无奈多数视频平台上的美剧都是收费的。对于一个资深Pythoner,我们可以用Python自动获取美剧的网址,下载了慢慢看。
我们以天天看M剧这个网站为例,来展示如何分析和下载这些内容,这里提供一种思路供大家学习。当然,我们还是得支持正版内容,这里是介绍技术,大家勿用于非法用途哦,电影下载后请遵照网站协议及时删除。
准备网址
网址大家自己找。我们在主页搜索“危机边缘”
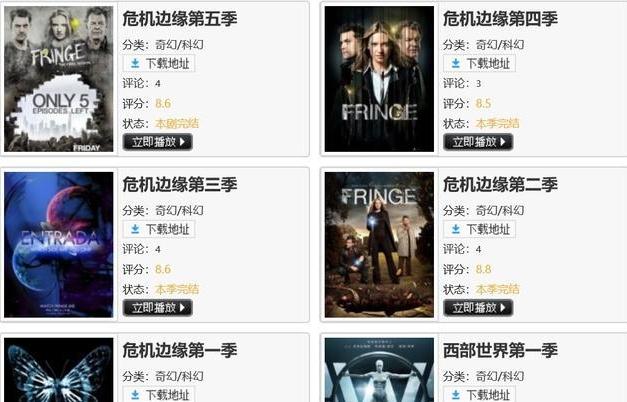
然后我们获得1-5季的网址内容,如下图
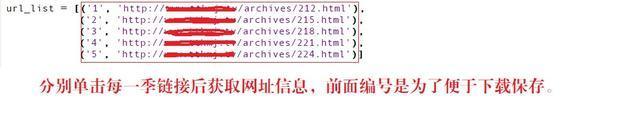
我们知道了1-5季的网址信息,然后,我们来看一下每一个页面的结构。
分析页面内容
我们打开第一季的页面,看下需要获取的内容,如下图:
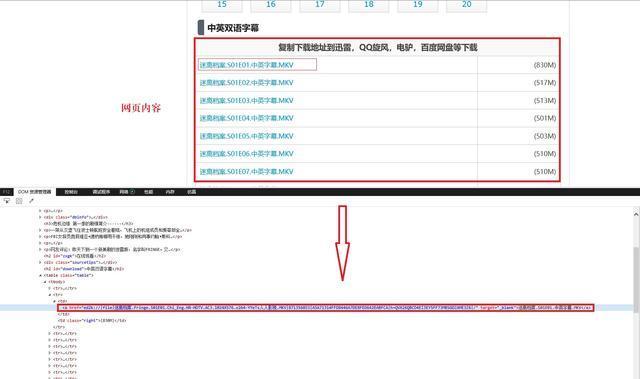
我们需要的是每一集的网址信息(上图中红色框线中的内容),通过将各个季的每一集网址内容下载下来,按季保存为txt文件,然后使用下载工具导入下载即可。
Python如何实现
我们知道,爬取信息主要使用的一些经典库。
我们这里主要使用两个经典的库requests和bs4。亲测该网站没有反爬措施,因此我们没有涉及这些内容,感兴趣的小伙伴自己学习下相关内容。
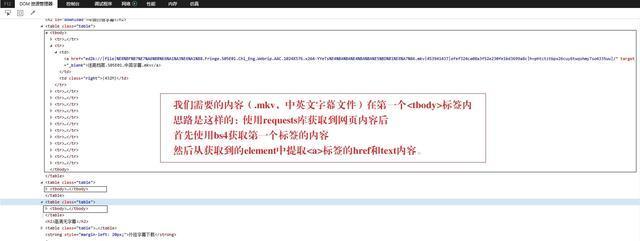
我们的一般思路是这样的,下面来看下Python实现过程。
我们定义三个函数,主要代码如下:
【获取网页内容】
def getHtml(url):return requests.get(url)
直接返回了网页的文本内容。
【获取每页网址信息】
def getInfo(html):lst = []bs = BeautifulSoup(html.text, ’html.parser’)urls = bs.findAll(’tbody’)[0]for item in urls.findAll(’a’):lst.append((item.get('href'), item.text))return lst
传入每一季的页面内容,以列表信息返回每一集的网址和每一集的名字。
【保存内容】
def saveInfo(name, lst):with open(’第{}季.txt’.format(name), ’w’) as f:for item in lst:f.write(item[0] + ’n’)
传入每一季的名称的该季中的每一集的网址列表,保存在本地。
做轮子
没错,简单的三步实现了我们需要的效果。下面,我们开始“造轮子”。
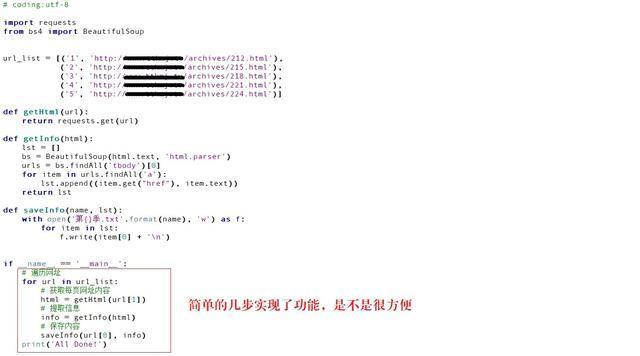
下面我们来看看我们实现的功能。
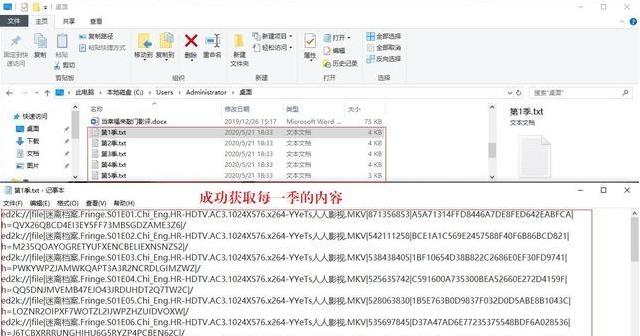
好了,我们的内容成功获取到了,然后自己下载吧!
程序扩展
聪明的小伙伴一定想到了,还有很多好看的美剧呢,我们如何下载其它的内容呢?
如何下载其它视频呢?
过程同上,先到主页搜索,然后更改我们的url_list列表,执行程序即可!接触过前端的小伙伴肯定知道,每个网站的结构基本是相同的,我们这样的方法在天天看M剧的主页上应该是通用的。感兴趣的小伙伴自己下载看看咯。
到此这篇关于如何用python免费看美剧的文章就介绍到这了,更多相关Python看美剧的方法内容请搜索好吧啦网以前的文章或继续浏览下面的相关文章希望大家以后多多支持好吧啦网!
相关文章:
1. SSM框架JSP使用Layui实现layer弹出层效果2. AJAX跨域问题解决方案详解3. Python使用Selenium自动进行百度搜索的实现4. XML解析错误:未组织好 的解决办法5. Matplotlib可视化之添加让统计图变得简单易懂的注释6. Ajax 的初步实现(使用vscode+node.js+express框架)7. openai createChatCompletion函数使用实例8. 详解CSS样式中的!important、*、_符号9. Python常用数据分析模块原理解析10. 一个用xslt样式将xml解析为xhtml的类TransformBinder(兼容FF和IE7.0)
 网公网安备