文章详情页
Python Selenium实现无可视化界面过程解析
浏览:247日期:2022-07-13 10:04:48
无可视化界面的意义
有时候我们爬取网页数据,并不希望看其中的过程,只想看到最后的数据结果就可以了,这时候,***面就很有必要了!
代码如下
from selenium import webdriverfrom time import sleep#实现无可视化界面from selenium.webdriver.chrome.options import Options#实现规避检测from selenium.webdriver import ChromeOptions#实现无可视化界面的操作chrome_options = Options()chrome_options.add_argument(’--headless’)chrome_options.add_argument(’--disable-gpu’)#实现规避检测option = ChromeOptions()option.add_experimental_option(’excludeSwitches’, [’enable-automation’])#如何实现让selenium规避被检测到的风险bro = webdriver.Chrome(executable_path=’./chromedriver’,chrome_options=chrome_options,options=option)#无可视化界面(无头浏览器) phantomJsbro.get(’https://www.baidu.com’)print(bro.page_source)sleep(2)bro.quit()
运行效果:
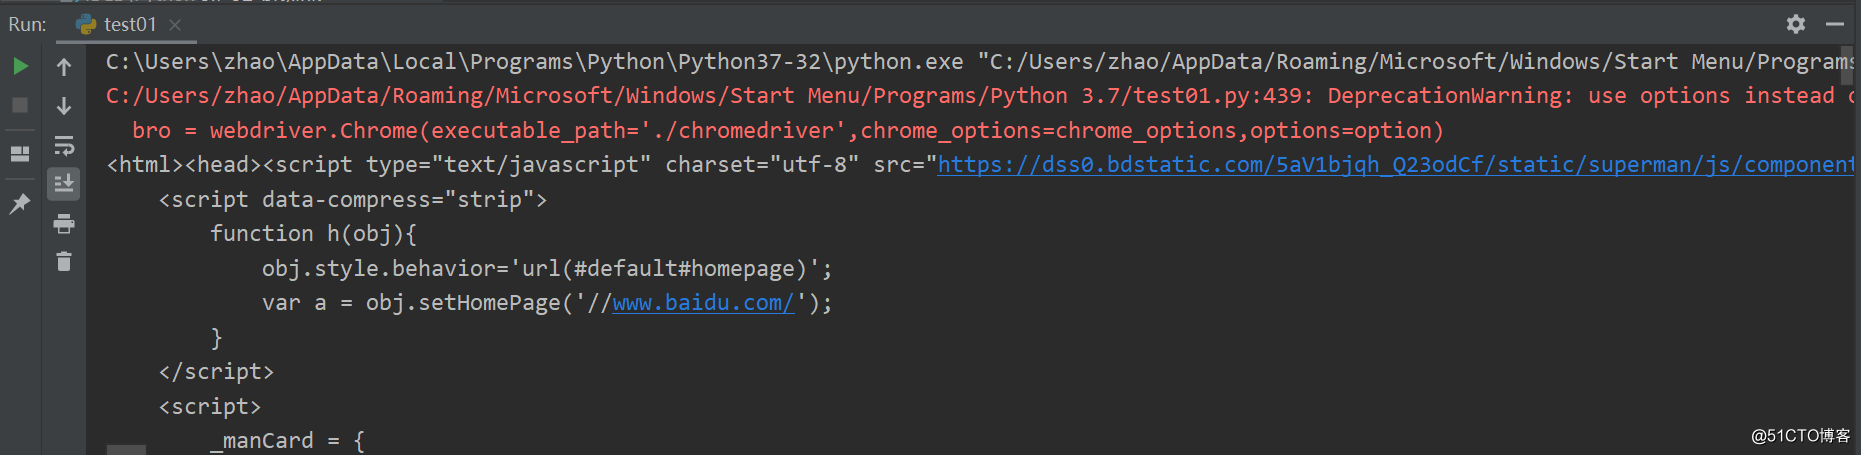
打印出网页代码,证明爬取网站信息成功
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持好吧啦网。
相关文章:
1. 详解CSS故障艺术2. vscode运行php报错php not found解决办法3. 一个用xslt样式将xml解析为xhtml的类TransformBinder(兼容FF和IE7.0)4. PHP组合模式Composite Pattern优点与实现过程5. python基于tkinter实现gif录屏功能6. Jsp servlet验证码工具类分享7. 页面遮罩层,并且阻止页面body滚动。bootstrap模态框原理8. Spring MVC+ajax进行信息验证的方法9. ThinkPHP6使用JWT+中间件实现Token验证实例详解10. asp画中画广告插入在每篇文章中的实现方法
排行榜
 网公网安备