python - 如何爬取豆瓣电影的详细信息
问题描述
我想爬取每个电影的制片国家地区,但是它上面并不在一个标签里面应该怎么办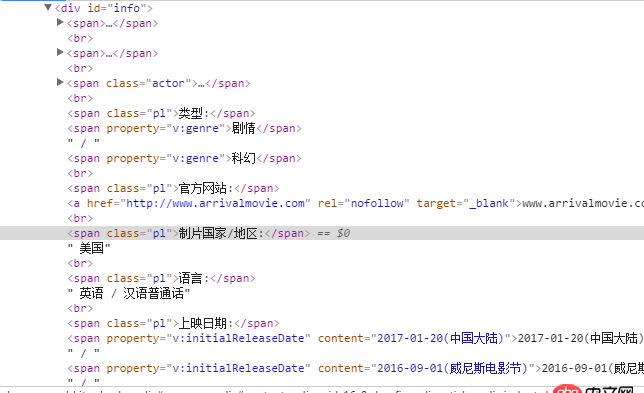 我用的是request和BeautifulSoup
res2=requests.get(h2)res2.encoding=’utf-8’soup2=BeautifulSoup(res2.text)
这部分是已经获取该网页
问题解答
回答1:参考以下代码:
#!/usr/bin/env python# -*- coding:utf-8 -*-import reimport requestsfrom bs4 import BeautifulSoupresult = requests.get(’https://movie.douban.com/subject/3541415/’)result.encoding = ’utf-8’soup = BeautifulSoup(result.text, ’html.parser’)try: info = soup.select(’#info’)[0] print re.findall(ur’(?<=制片国家/地区: ).+?(?=n)’, info.text)[0]except Exception, e: print e回答2:
正则匹配</span>和<br>之间的内容。
回答3:1、可以用正则
2、建议用soup.find_all看文档
https://www.crummy.com/softwa...
soup.find_all('title')# [<title>The Dormouse’s story</title>]soup.find_all('p', 'title')# [<p class='title'><b>The Dormouse’s story</b></p>]soup.find_all('a')# [<a href='http://example.com/elsie' id='link1'>Elsie</a>,# <a href='http://example.com/lacie' id='link2'>Lacie</a>,# <a href='http://example.com/tillie' id='link3'>Tillie</a>]soup.find_all(id='link2')# [<a href='http://example.com/lacie' id='link2'>Lacie</a>]
黄哥Python 回答
相关文章:
1. css3动画 - css3 transition设置多个属性的时候不能只用逗号分隔?2. MySQL分表之后如何做排序的问题3. java - 为什么第一个线程已经释放了锁,第二个线程却不行?4. javascript - nodejs抓取网页的问题5. 前端 - css自定义字体6. java - 接口中的成员变量怎么不是常量了?7. 登录界面URL在服务器上无法找到8. javascript - nodejs报错 打开localhost:3000 就报错9. mysql在进行insert select的时候,有的字段跟关键字重复怎么处理?10. html - 如何删除css文件中没有被引用的类?
 网公网安备