csv - python多列存取爬蟲網頁?
问题描述
爬虫抓取的资料想分列存取在tsv上,试过很多方式都没有办法成功存存取成两列资讯。想存取为数字爬取的资料一列,底下类型在第二列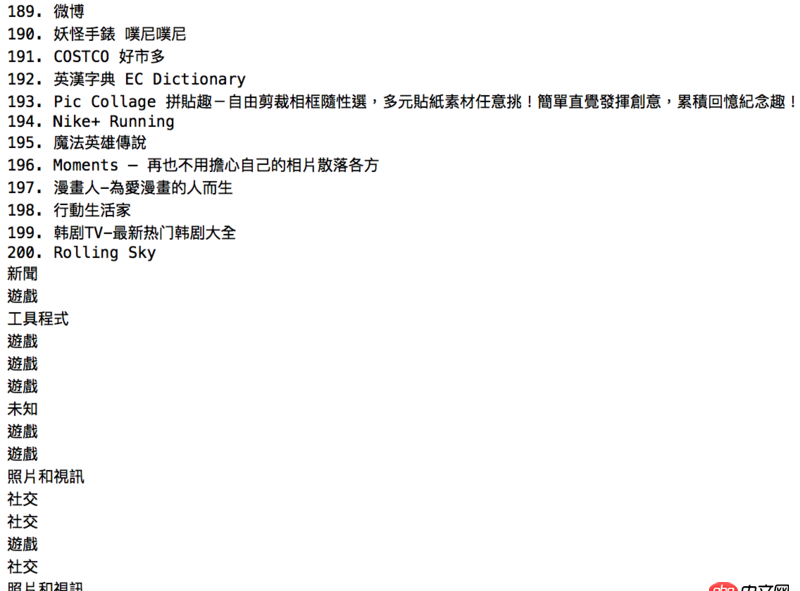
from urllib.request import urlopenfrom bs4 import BeautifulSoupimport reimport csvhtml = urlopen('http://www.app12345.com/?area=tw&store=Apple%20Store')bs0bj = BeautifulSoup (html)def GPname(): GPnameList = bs0bj.find_all('dd',{'class':re.compile('ddappname')}) str = ’’ for name in GPnameList:str += name.get_text()str += ’n’print(name.get_text()) return strdef GPcompany(): GPcompanyname = bs0bj.find_all('dd',{'style':re.compile('color')}) str = ’’ for cpa in GPcompanyname:str += cpa.get_text()str += ’n’print(cpa.get_text()) return strwith open(’0217.tsv’,’w’,newline=’’,encoding=’utf-8’) as f: f.write(GPname()) f.write(GPcompany())f.close()
可能对zip不熟悉,存取下来之后变成一个字一格也找到这篇参考,但怎么尝试都没有办法成功https://segmentfault.com/q/10...
问题解答
回答1:写csv文件简单点 你的结构数据要成这样 [['1. 東森新聞雲','新聞'],['2. 創世黎明(Dawn of world)','遊戲']]
from urllib import urlopenfrom bs4 import BeautifulSoupimport reimport csvhtml = urlopen('http://www.app12345.com/?area=tw&store=Apple%20Store')bs0bj = BeautifulSoup (html)GPnameList = [name.get_text() for name in bs0bj.find_all('dd',{'class':re.compile('ddappname')})]GPcompanyname = [cpa.get_text() for cpa in bs0bj.find_all('dd',{'style':re.compile('color')})]data = ’n’.join([’,’.join(d) for d in zip(GPnameList, GPcompanyname)])with open(’C:/Users/sa/Desktop/0217.csv’,’wb’) as f: f.write(data.encode(’utf-8’))
相关文章:
1. javascript - 百度坐标,返回目标附近有哪些坐标2. javascript - 关于jsp中嵌入js代码的问题3. javascript - 一个JS多元运算符的问题4. javascript - 有一个异步获取数据的函数A,其他依赖这个A得到的数据的函数是否都必须是异步的?5. javascript - 有什么兼容性比较好的办法来判断浏览器窗口的类型?6. javascript - html5多个label中其中一个触发change,如何判断是哪一个出发了change7. javascript - 关于fullpage.js的横向滚动控制8. javascript - 判断用户网络环境9. clone - git sourceTree克隆仓库时,都不停弹出Password Required弹窗,即时输入正确的git账号密码还是弹出10. angular.js - angurlarJS的安卓的微信端中用加载ngCookies会出错的问题
 网公网安备