文章详情页
python - 基于scrapy-redis的分布式爬虫运行的时候不能正常运行 遇到的问题如下截图所示
浏览:284日期:2022-08-03 11:20:00
问题描述
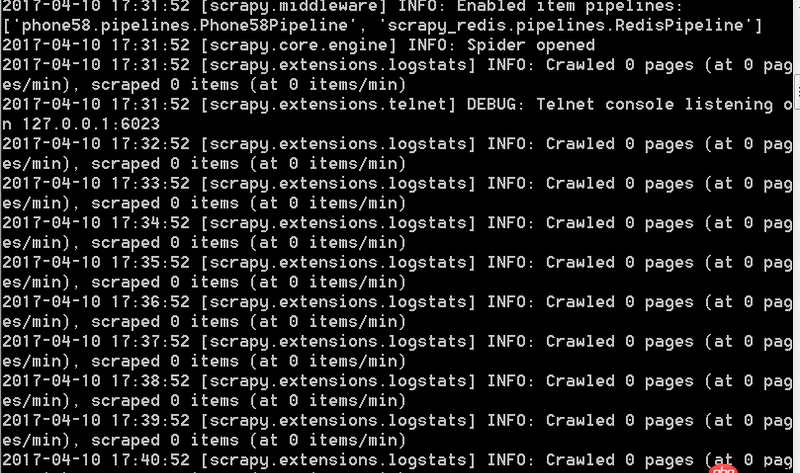
爬虫运行时一直是这样的每一分钟出现一条这样的信息,无限循环。不能爬取下来数据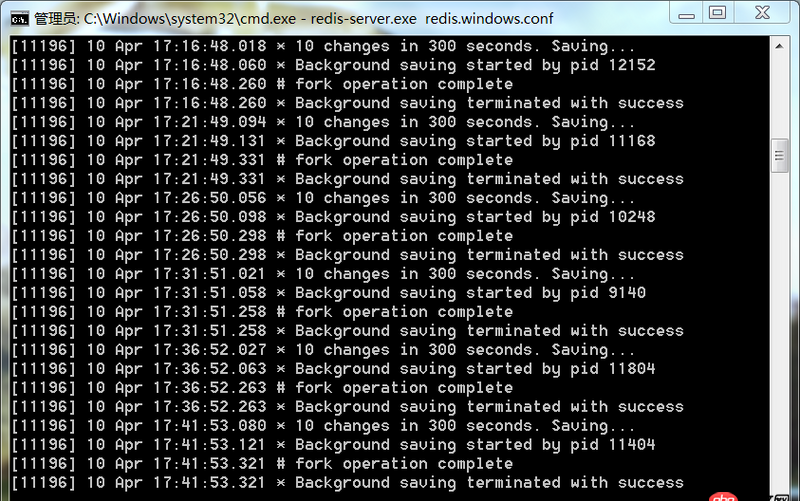
这是redis服务端的显示
这样是什么问题,望有高手可以为我解惑,谢谢。
问题解答
回答1:使用scrapy_redis,你要去投放url让spider去爬取,你投放了吗?比如
redis-cli lpush myspider:start_urls http://google.com
相关文章:
1. javascript - react 中绑定事件和阻止事件冒泡2. css3 - css line-height和font-size高度问题,谁能帮忙解释一下呢3. java - .jsp页面用<%= %>的方式获取数据存在一个很奇怪的问题4. javascript - git clone 下来的项目 想在本地运行 npm run install 报错5. sping - Spring注入,在XML配置中引用JavaConfig,结果找不到Config中的bean6. javascript - requestAnimationFrame如何控制帧速?7. css3 - border-bottom 的长度可否超过盒子的宽度呢?实现如下图效果。(我的书下面的线)8. vue.js - nginx怎么修改跨域配置?9. 一道使用算法解决的java题(关于hashmap的问题)10. java - umeng分享中遇到找不到方法
排行榜
 网公网安备