文章详情页
python - scrapy 爬取pages比实际进入items的多得多?
浏览:237日期:2022-07-23 10:55:26
问题描述
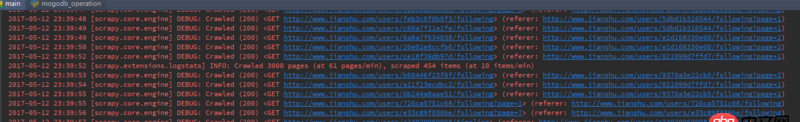
2017-05-12 23:39:52 [scrapy.extensions.logstats] INFO:Crawled 3000 pages (at 61 pages/min), scraped 454 items (at 10 items/min)
为什么我使用scrapy爬取的时候访问pages要比实际进入items的的多的多?就是爬了半天items里没有几条数据入库的有什么办法解决么?
问题解答
回答1:重定向了,你看到了吧,重定向就得请求两个页面啊。还有就是看有不有页面解析发生了错误。
相关文章:
1. node.js - nodejs+express+vue2. node.js - vue-resource,如何改变响应格式?3. javascript - Node.js中输出顺序为什么和预期的不一样呢?4. 一道使用算法解决的java题(关于hashmap的问题)5. css3 - 在手机app端实现点击缩略图展示原图6. python - 用ffmpeg采集视频,用terminate没法结束进程7. javascript - 导出多条数据的时候,如何动态的赋值id?8. javascript - 怎么在DIV图片上加个DIV,并带有按钮链接呢?9. java - 使用solrj创建索引时遇到的奇怪问题?10. nginx - 关于vue项目部署到ngnix后出现的问题
排行榜
 网公网安备