文章详情页
python - 使用scrapy框架爬百度图片被墙
浏览:269日期:2022-06-30 14:19:37
问题描述
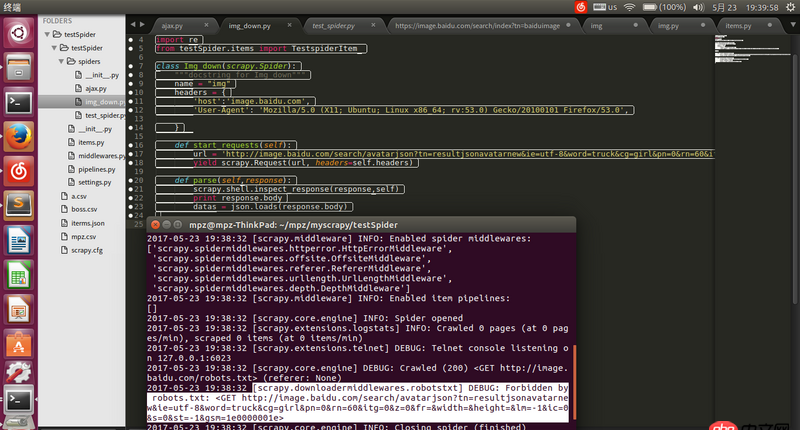
请求地址url是通过firefox查看得到的json的地址,用浏览器可以打开,但是用scrapy爬的时候就被ban了求解决办法。
https://image.baidu.com/searc...
问题解答
回答1:在 settings.py 将 ROBOTSTXT_OBEY = False 试试。
回答2:不要加hearders试试
回答3:赞成楼上,如果还会被墙。可采用scrapy+selenium+phantomjs的方式。
相关文章:
1. MYSQL 运算的问题2. mysql - 数据库中的引擎和表的引擎的区别在哪?3. javascript - 如图,百度首页,查看源代码为什么什么都没有?4. python - Scrapy的使用,如何请求新的URL,并回调指定的函数?5. mysql - 求一个sql语句,比较简单。6. node.js - win10如何安装并使用babel?7. mysql - 数据库字段命名问题,新人,求解8. web服务器 - ubuntu下布置apache加wsgi加python9. 求救一下,用新版的phpstudy,数据库过段时间会消失是什么情况?10. mysql - 一个sql的问题
排行榜
 网公网安备