网页爬虫 - python 爬虫怎么处理json内容
问题描述
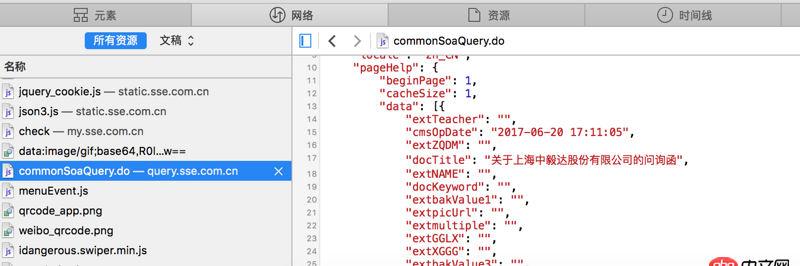
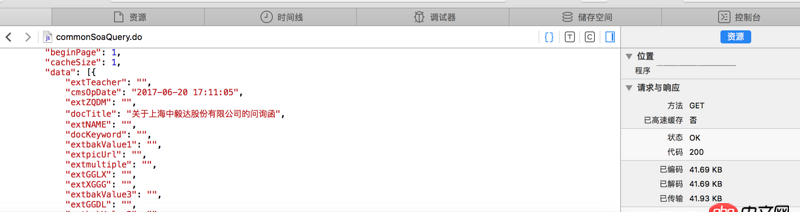
看不清的话 网站地址是http://www.sse.com.cn/disclos...红字是我需要的内容 但是我提取不出来求教怎么操作
问题解答
回答1:import requestsurl = ’http://query.sse.com.cn/commonSoaQuery.do?siteId=28&sqlId=BS_GGLL&extGGLX=&stockcode=&channelId=10743%2C10744%2C10012&extGGDL=&order=createTime%7Cdesc%2Cstockcode%7Casc&isPagination=true&pageHelp.pageSize=15&pageHelp.pageNo=1&pageHelp.beginPage=1&pageHelp.cacheSize=1&pageHelp.endPage=5’headers = { ’Referer’:’http://www.sse.com.cn/disclosure/credibility/supervision/inquiries/’, ’User-Agent’:’Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36’}r = requests.get(url, headers=headers)print r.json()[’result’]回答2:
import requestsurl = ’http://query.sse.com.cn/commonSoaQuery.do?siteId=28&sqlId=BS_GGLL&extGGLX=&stockcode=&channelId=10743%2C10744%2C10012&extGGDL=&order=createTime%7Cdesc%2Cstockcode%7Casc&isPagination=true&pageHelp.pageSize=15&pageHelp.pageNo=1&pageHelp.beginPage=1&pageHelp.cacheSize=1&pageHelp.endPage=5&_=1498029409382’session = requests.session()session.headers.update({ ’Referer’: ’http://www.sse.com.cn/disclosure/credibility/supervision/inquiries/’, ’User-Agent’: ’Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36’})result = session.get(url).json()print result
相关文章:
1. android-webview - Android 7.0 webview不自动刷新2. vue.js - vue开发的项目,想在页面打开的时候使input自动聚焦,使用的官方的自定义指令,但是在ios真机上测试无效3. javascript - 用atom安装linter-eslint插件出错4. shell - mac bash: mysql: command not found5. javascript - 怎么在DIV图片上加个DIV,并带有按钮链接呢?6. python - 用ffmpeg采集视频,用terminate没法结束进程7. javascript - 用console.log调试JS是不是很不专业?8. ruby - 添加国内淘宝gem源失败9. javascript - 关于pc端网站的浏览器兼容问题!10. MySQL的合计函数这里为什么报错?
 网公网安备