网页爬虫 - python 爬取网站 并解析非json内容
问题描述
小弟刚学会获得json的内容,但今天爬的网站返回的并不是json内容 并且会有一个随机数的生成在每次请求链接的后面
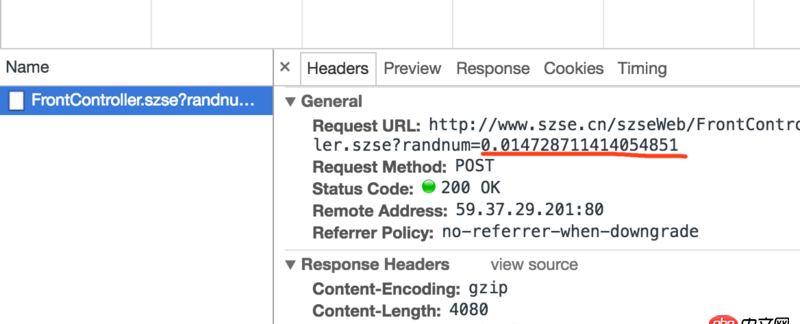
不知道会不会影响我要爬的内容
需要获得内容是下图中间的内容
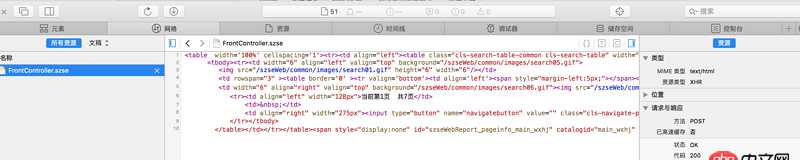 网站链接 http://www.szse.cn/main/discl...
我自己尝试的代码:
import requestsdir = ’/Users/S1Lence/Desktop/new_html/szse/许可类重组问询函’headers = {’Host’: ’www.szse.cn’, ’Referer’: ’http://www.szse.cn/main/disclosure/jgxxgk/wxhj/’, ’User-Agent’: ’Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_5) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.109 Safari/537.36’ }payload= {’ACTIONID’: ’7’, ’AJAX’: ’AJAX-TRUE’, ’CATALOGID’: ’main_wxhj’, ’TABKEY’: ’tab1’, ’selecthjlb’: ’许可类重组问询函’, ’tab1PAGENO’: ’1’, ’tab1PAGECOUNT’: ’7’, ’tab1RECORDCOUNT’: ’63’, ’REPORT_ACTION’: ’navigate’}res = requests.post(’http://www.szse.cn/szseWeb/FrontControllere’, data=payload)print(res.text)
输出的内容并不是我想要的 求解应该怎么爬
问题解答
回答1:把他的header信息拷过来用。。
回答2:你post的url地址写错了,应该是
http://www.szse.cn/szseWeb/FrontController.szse
相关文章:
1. PHP类属性声明?2. javascript - chart.js如何修改某个指定bar的颜色3. javascript - [MUI 子webview定位]4. PHP怎么升级?升级会导致老的网站程序不能用吗?5. javascript - input 怎么获取自动填充的值6. node.js - 我是一个做前端的,求教如何学习vue,node等js引擎?7. 存储过程 - Mysql时间参数 问题8. css3 - 没明白盒子的height随width的变化这段css是怎样实现的?9. mysql主从 - 请教下mysql 主动-被动模式的双主配置 和 主从配置在应用上有什么区别?10. php - mysql多表查询
 网公网安备